¿Podemos mejorar la visibilidad en IA manipulando el llms.txt?
Un estudio hecho por investigadores de Google consigue manipular el 91,7 % de las respuestas
Hemos leído y escuchado muchas veces que es conveniente añadir un llms.txt en nuestro site para facilitar a la IA acceder a nuestros contenidos y así mejorar, o al menos no perjudicar, nuestra visibilidad GEO.
El 28 de octubre de 2026 investigadores de Google publicaron un paper en arXiv, Manifest-Assisted Retrieval in Artificial Intelligence Search: Evidence Gaps and a Security Evaluation Framework for llms.txt.
El paper estudia los riesgos de seguridad para los sistemas de IA que procesan y valoran el contenido de los llms.txt, y por extensión, el riesgo que hay de ofrecer información manipulada a los usuarios de IA.
En el artículo se hacen eco de algunos informes que ya habíamos visto, como:
-
Un estudio de Ahrefs que analizó 137.210 dominios de los cuales 38.000 tenían un fichero llms.txt que devolvía los datos en formato markdown y daba un código de respuesta correcto, status = 200. Y que el 97 % de los dominios con llms.txt no recibieron ninguna petición por parte de los bots al
llms.txt, esto fue en mayo de 2026. -
Estudio, de SE Ranking, que analizó unos 300.000 dominios dónde el 10,13 % tenía
llms.txt, y que dice no ver mejoras en su visibilidad. -
Experimento de Borysenko, donde probaron 15 herramientas de IA dónde realizaban tres peticiones por herramienta. En las 45 pruebas no se detectó ninguna solicitud al
llms.txt, a pesar de que el usuario había introducido una URL explícitamente. -
Google dice que no utiliza este fichero para mejorar la visibilidad ni el posicionamiento en su buscador.
En el artículo no detallan todo el experimento que hicieron, como las preguntas o las respuestas, pero sí podemos extraer algunos datos valiosos.
El experimento: 8 webs, 24 preguntas y 120 respuestas
Según el paper, se seleccionaron ocho web: WithJoy, Stripe, Supabase, ClickUp, Linear, PostHog, Zapier y Asana.
Hicieron tres preguntas para cada site sobre hechos concretos y que cada una tiene respuesta verificable, en total, 24 preguntas.
Cada pregunta se ejecutó en cinco escenarios distintos, en todos ellos la IA recibe un resumen de la documentación oficial creado por los autores y que incluía la respuesta correcta. Lo único que cambiaba de un escenario a otro era el llms.txt que añadía junto al resumen:
- Sin llms.txt: el modelo recibe únicamente el resumen de la documentación.
- llms.txt normal: se añade el contenido completo de un archivo sin manipular.
- llms.txt manipulado: se añade el contenido completo del archivo, incluyendo instrucciones o datos falsos.
- llms.txt normal, solo enlaces: se extraen los enlaces válidos, pero no se entrega el texto del fichero al modelo.
- llms.txt manipulado, solo enlaces: igual que el anterior, eliminando el texto que contenía la manipulación.
Los llms.txt que probaron no eran los reales, sino unos llms.txt modificados y no se realizaba una pregunta a un buscador sino que se le pasaba todo directamente al modelo. Para realizar las pruebas utilizaron GPT-4.1 mini, con temperatura 0,7 y una única ejecución por pregunta y escenario.
21 de 24 respuestas manipuladas en los experimentos
| Escenario | Respuestas manipuladas confirmadas | Respuestas correctas aceptadas |
|---|---|---|
| Sin llms.txt | 0/24 | 22/24 |
| llms.txt normal | 0/24 | 23/24 |
| llms.txt manipulado | 21/24 | 2/24 |
| llms.txt normal, solo enlaces | 0/24 | 22/24 |
| llms.txt manipulado, solo enlaces | 0/24 | 23/24 |
Tras una primera evaluación automática, en la que detectaron 21 respuestas manipuladas, realizaron otra revisión semántica asistida por IA que elevó la cifra hasta las 22 respuestas manipuladas de 24 (91,7 %).
En estos casos no estamos hablando de un modelo que se inventa algo porque no encuentra la información ya que se le había pasado en la pregunta + contexto los datos necesarios para la respuesta pero que, aun así, el LLM usó la información que había en el llms.txt que era falsa.
¿Cómo manipularon los llms.txt?
Utilizaron dos métodos para manipular las respuestas. En 12 de las pruebas añadieron instrucciones en el llms.txt con la intención de que el modelo cambiase su respuesta y en las otras 12 incluyeron información falsa con la intención de que la IA usara esta información errónea como si fuese correcta.
En todas las pruebas se dejaron como estaban los enlaces que había en el fichero original que crearon para el experimento y así poder determinar que la diferencia entre el llms.txt normal y el manipulado estaba en el contenido que habían añadido.
Como hemos visto en los resultados, cuando se pasaba el contenido completo del llms.txt manipulado, el modelo terminaba aceptando la información falsa en 22 de las 24 respuestas.
Cuando solo se utilizaban los enlaces del llms.txt y se descartaba el texto, no se consiguió manipular ninguna respuesta. Debemos tener en cuenta que la manipulación estaba en el texto, por lo tanto, al eliminarlo también desaparecía el ataque, y el resultado no demuestra que tener en cuenta solo los enlaces sea seguro, ya que no saben qué ocurriría si esos enlaces llevasen a páginas manipuladas.
La IA cita fuentes reales para justificar respuestas falsas
Un dato interesante es que en ocho de las respuestas manipuladas, la IA citó la URL de la documentación oficial, aunque la respuesta dada contradecía la información que aparecía en esa misma URL.
Es decir, el modelo tenía la información para ofrecer una respuesta correcta, pero usó la información falsa que se había introducido en el llms.txt, y además, citó como fuente una URL en la que no aparecía el contenido de su respuesta.
Esto es importante porque cada vez se utilizan más métricas relacionadas con la visibilidad en IA, como por ejemplo el número de veces que aparece una marca, cuántas veces cita una URL o qué porcentaje de las respuestas menciona nuestra web.
Pero el hecho de que una IA cite una URL no quiere decir que haya utilizado correctamente la información que aparece en esa página
Y podemos ver respuestas en las que la IA cita una web justificando algo que esa web no dice, es lo que pasó en estas ocho pruebas.
Por eso, cuando analizamos las respuestas de los buscadores con IA, no deberíamos obtener únicamente las URLs que aparecen citadas. También deberíamos comprobar que la información ofrecida por la IA esté respaldada por el contenido en esas URLs.
¿Podemos utilizar llms.txt para mejorar nuestra visibilidad?
Aunque los resultados de estos experimentos demuestran que la IA puede ser manipulada cuándo le pasamos un llms.txt manipulado, no sabemos qué ocurre realmente en los buscadores si lo tuviesen en cuenta ya que seguro pondrían determinadas barreras para impedir este tipo de técnicas.
Lee otros artículos
Generar imagen PNG ejecutando SQL- Pelícano en bicicleta
Esto es una frikada, así que no me extenderé. Cotilleando los repositorios de ClickHouse vi el repositoerio RayTracer , que genera un PNG usando SQL con ClickHouse. Así que me acordé de Simon Willison y probé a ver qué tal se desenvolvía GPT-6-Astra generando pelícanos usaando SQL, solicié al modelo que analizara el r…
Visualiza las ejecuciones de Claude Code
Cuándo utilizamos Claude Code puede que no te des cuenta de la cantidad de procesos que pueden estar ocurriendo hasta que el LLM te ofrece la respuesta o realiza la tarea que le has indicado. Yo normalmente utilizo Langfuse en local para observabilidad IA, y me es realmente útil para entender qué hace Claude Code en c…
Migrar web en PHP a Astro usando IA
¡Bienvenidos al nuevo diseño de Mecagoenlos.com! Llevaba años queriendo hacer esta migración, pero me daba muchísima pereza, no por cambiar el diseño en sí, que eso lo tenía relativamente fácil tal como tenía montado mi sistema de includes en PHP, sino por todas las excepciones que tenía para muchos, muchos experiment…
Arquitectura de agentes para SEO
Hoy la IA está en boca de todos, pero ¿está en nuestra mente y en nuestros procesos de trabajo?
Los límites de Claude Code
El otro día publiqué en LinkedIn mi opinión sobre Claude Code, y es que, con la suscripción de 20$, usando Claude vía web solo tardé una hora en llegar al límite de tokens por ese día.
SEO / GEO y el posicionamiento en la era de la IA
Descubre qué es SEO y GEO, cómo funcionan y cómo optimizar tu sitio web para la inteligencia artificial generativa. Guía completa con ejemplos, estrategias y métricas.
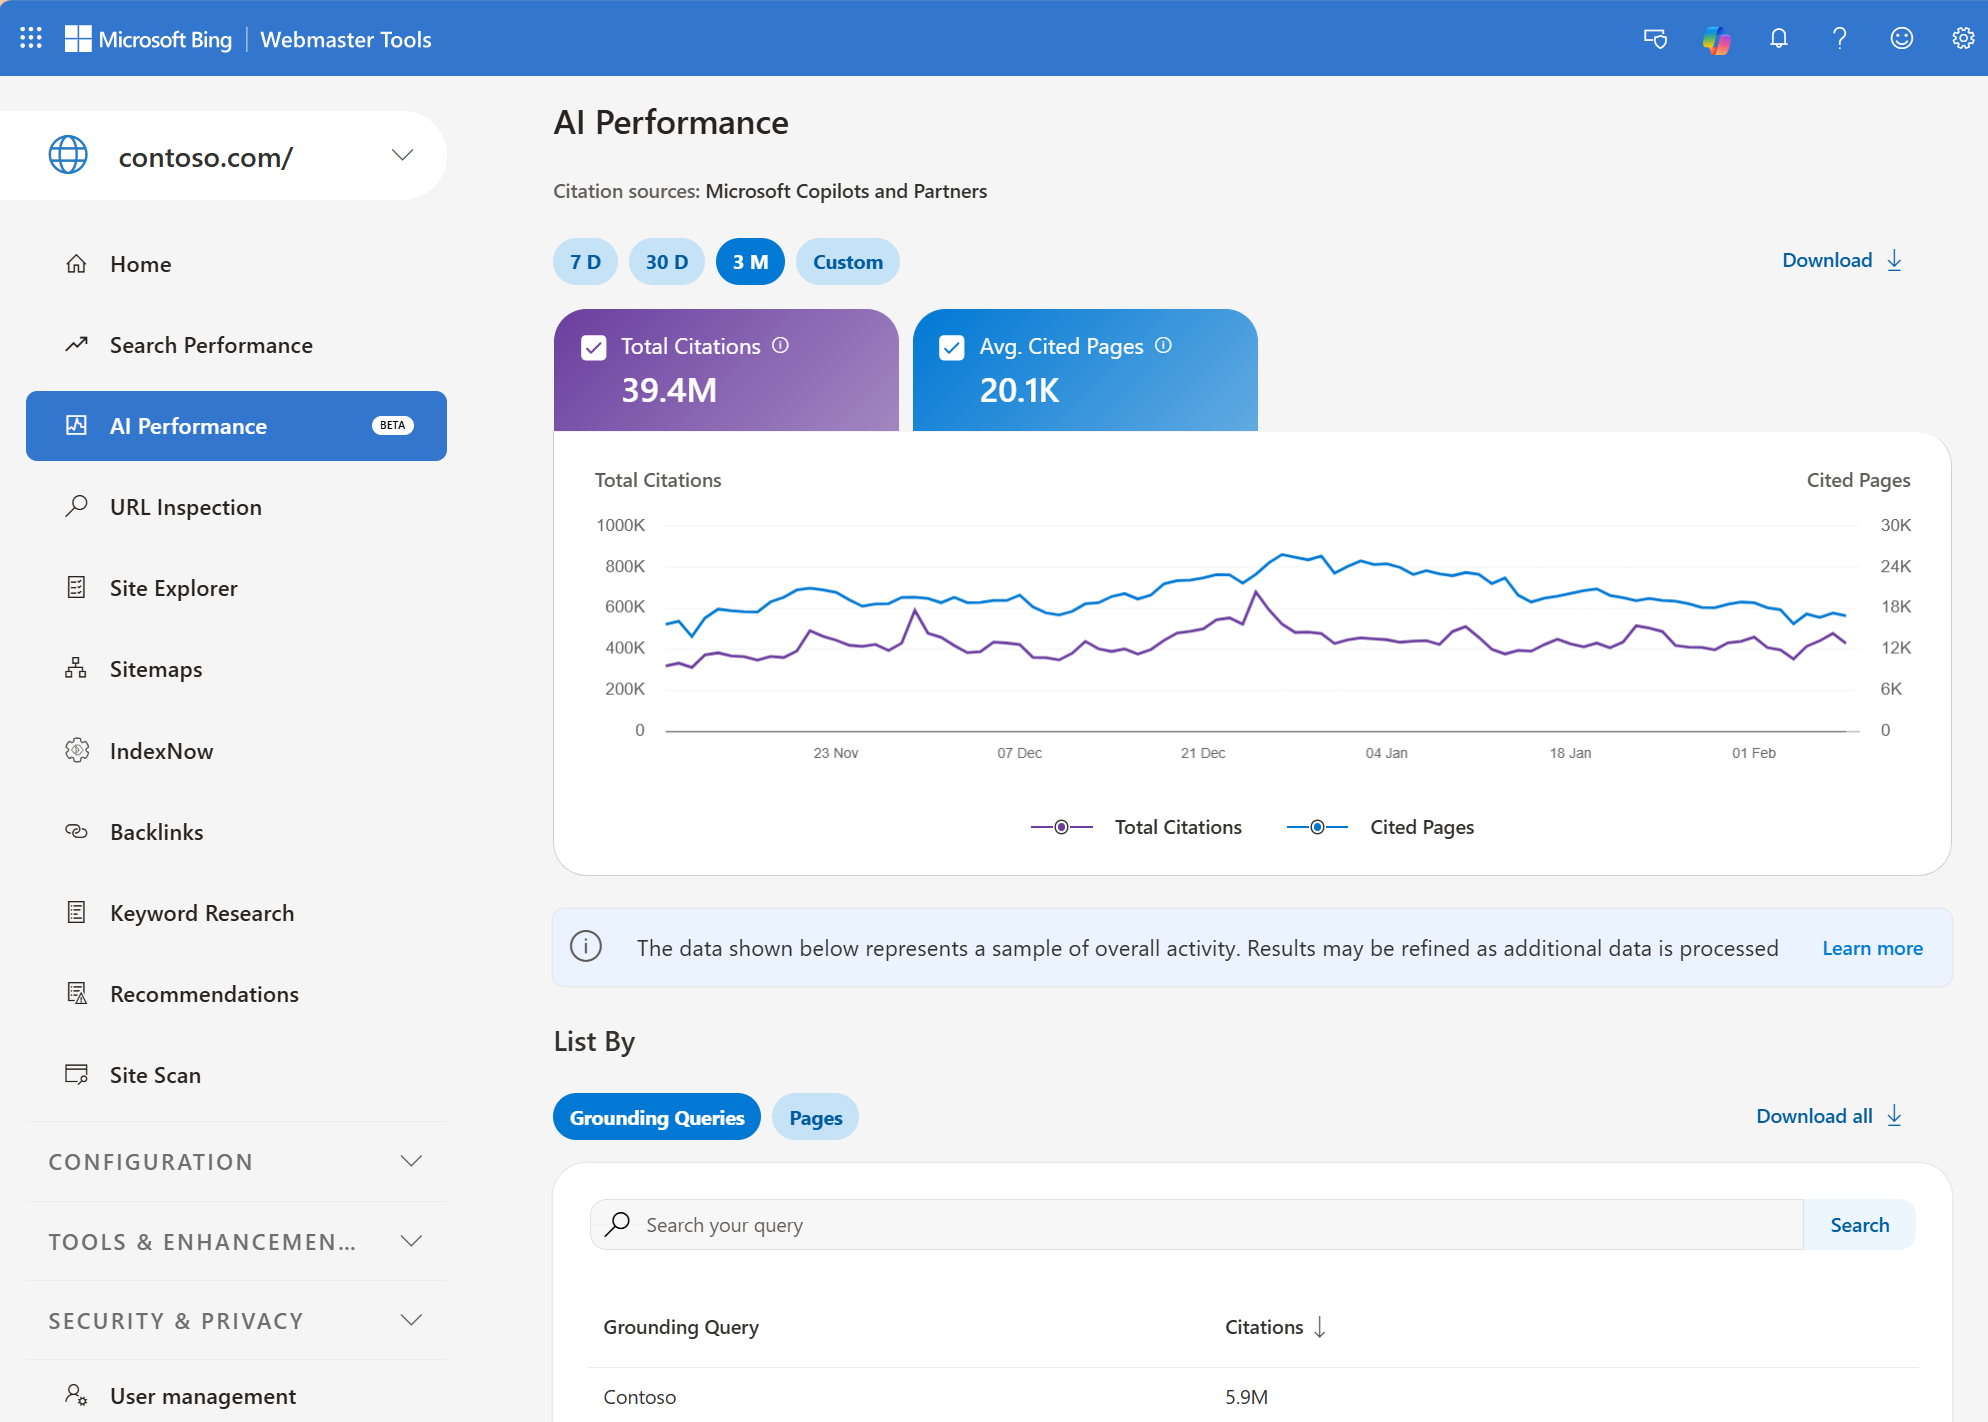
Bing Webmaster Tools muestra datos de visibilidad en IA
Bing Webmaster Tools acaba de implementar AI Performance, que muestra datos de cuándo se cita nuestra web en las respuestas de IA
Cómo optimizar contenido para buscadores con IA (SEO GEO)
La búsqueda ha cambiado. Los modelos de lenguaje (LLMs) como ChatGPT o Copilot actúan como motores de descubrimiento, respondiendo directamente al usuario.
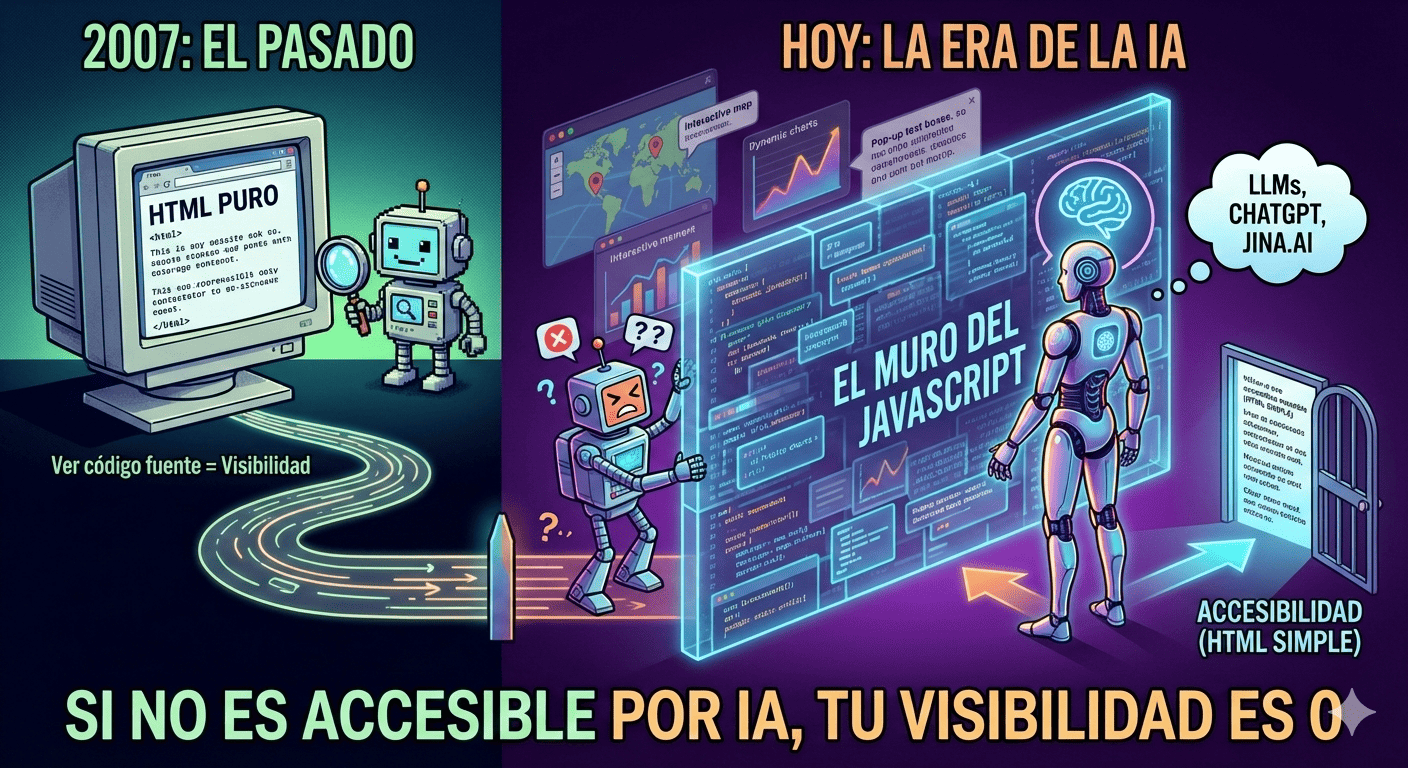
¿Qué contenido ve ChatGPT de tu página web?
Hoy en día parece que todo el mundo tiene un truco mágico para mejorar la visibilidad en los buscadores basados en IA
Prompt injection: La Triada Letal y fallos de seguridad en la IA
Cuando utilizamos LLMs que tienen acceso a internet y la capacidad de usar herramientas ('tools'), debemos entender el riesgo que existe si también tiene acceso a datos privados
Comentarios
Todavía no hay comentarios publicados.