Link desde Gmail
Desde hace ya unos años venimos viendo cómo Google es capaz de cargar e indexar ciertos contenidos via javascript, en este blog hemos hecho muchos experimentos sobre cómo Google rastrea e indexa el contenido cargado mediante
JavaScript.
Los últimos experimentos sobre Google e indexación de javascript fueron encaminados a intentar
saber si
Google era capaz de ejecutar funciones javascript "complejas" y si
era capaz de acceder e indexar el contenido cargado mediante llamadas
Ajax y hemos comprobado cómo Google accedía e indexaba estos contenidos por muy ofuscados que hiciéramos esas llamadas JavaScript, siempre y cuándo este código se ejecutara en el onLoad o en el onReady.
Definiciones previas
Lo primero vamos a definir un par de términos para poder referirnos más adelante a ellos:
- URL de origen:
Es la url que escribimos o vemos en el navegador. En este artículo la url de origen es
/Posicionamiento/interpreta-google-el-javascript.php
que es la url del anterior experimento.
- URLs cargadas via JavaScript:
URLs llamadas desde JavaScript para cargar contenido, en este artículo son las siguientes urls, y cada una carga un contenido diferente:
- /metodos-javascript-cargaContenido .php
- /metodos-javascript-cargaContenido .php?opcion=conMiniEspera
- /metodos-javascript-cargaContenido .php?opcion=conEspera
- /metodos-javascript-cargaContenido .php?opcion=conEspera10
- URLs de recursos
URLs de las hojas de estilo y ficheros js que se requieren para el renderizado completo del DOM. Por ejemplo:
- /includes/script_el-valor-de-los .js
- /Posicionamiento/assets/pages/css/components .css
- /Posicionamiento/assets/corporate/css/style .css
- /Posicionamiento/assets/corporate/css/custom .min.css
- /menu/css/component .css
Breve resumen sobre el experimento anterior
- Google es capaz de interpretar y ejecutar el javascript que se ejecuta de manera automática (siempre que no necesite de la interacción del usuario para ejecutarse), por ejemplo código en el onReady u onLoad.
- Por consiguiente, Google accede a todas las urls que cargan contenido mediante JavaScript si este código no necesita de la interacción del usuario para ejecutarse y obtener este contenido externo (en otra url). Por ejemplo contenido cargado con el evento onready o el evento onLoad.
- Google esperará, hasta más de 10 segundos (por lo menos) para cargar ese contenido y lo indexará. Por lo que podríámos eliminar el mito de que debe cargarse antes de 5 segundos... aunque aquí hay que hacer más pruebas para estar al 100% seguro, pero por lo que voy viendo así es.
- Google accede tanto a la url de origen (llamemos url de origen a la url que pone el usuario en la barra de direcciones del navegador) como a las url que son cargadas via JavaScript en esa url de origen.
- Google también accede a los recursos requeridos por un "navegador normal" como css, js, etc. No siempre carga todos los recursos que el DOM solicita, habrá que investigar si coincide con el tiempo de caché para ese tipo de recursos
- Google no accede a ninguna url que cargue contenido mediante eventos que lanza el usuario, por ejemplo onClick, onScroll, etc
- Google solo indexará el HTML FINAL, por lo que si un contenido es sustituido por otro mediante javascript Google indexará solamente el contenido final y no indexará el contenido que desaparece.
Los resultados y las conclusiones de este experimento los podéis ver con más detalle en este post sobre cómo ejecuta, rastrea e indexa el contenido cargado mediante javascript.
Analizando cuándo y qué urls renderiza Google
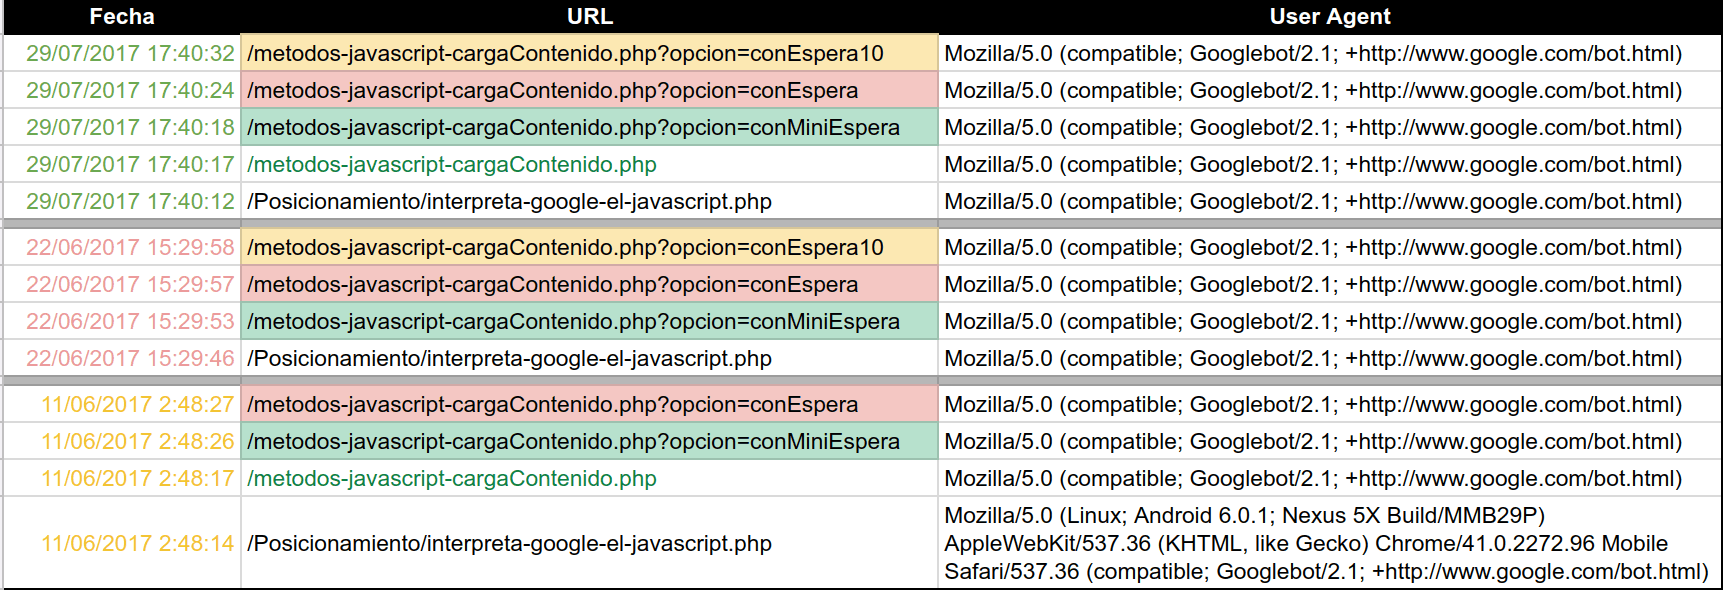
Cuando analizamos los logs del servidor generados por Google podemos
observar algo muy importante, y que a todos se nos había pasado por
alto, cuándo Google carga recursos como ficheros javaScript, hojas de estilo css o urls de contenido cargadas mediante ajax en todos estos casos lleva en el campo referer la url de origen, y esta es la url que está siendo renderizada!.
En este ejemplo podemos ver en el campo "URL" la URL de origen, con fondo verde, /Posicionamiento/interpreta-google-el-javascript.php, y en rojo las urls de contenido cargadas por javascript como por ejemplo /metodos-javascript-cargaContenido.php y también urls de hojas de estilos css o urls de recursos js.
No me había dado cuenta de la importancia de esto hasta que escuché la famosa presentación que Tom Greenaway y John Mueller dieron en el Google I/O de este 2018, dónde explicó cómo Google procesa los contenidos cargados mediante javascript.
Resumiendo podemos decir que Google procesa el contenido de una url en dos procesos / fases / oleadas. En una primera oleada Google funciona cómo siempre lo hemos entendido.
Primera oleada
- Accede a la url que tiene en su lista de urls a rastrear.
- Obtiene el HTML de esa url, sin ejecutar JavaScript. Es lo que vemos cuándo le damos al botón dercho del ratón y seleccionamos "Ver código fuente de la página").
- Evalua en base a multitud de variables ese HTML obtenido y decide si la indexa y qué imporancia da al contenido de esa url.
Pero John Mueller nos aclaró un tema muy importante, si en la url a la que accede Googlebot se carga contenido mediante javascript, Google volverá a acceder a esa url cuándo tenga recursos disponibles, y esta vez renderizando el DOM y ejecutando JavaScript, concretamente el navegador Chrome41, a esto lo ha denominado "la segunda oleada".
En esta segunda oleada Google realizará los siguientes pasos
Segunda oleada
- Accede a la url que tiene en su "lista de espera" por renderizar
- Obtiene el HTML de esa url.
- Evalua en base a multitud de variables el HTML de la url de origen renderizado, es decir evaluará el contenido y recursos cargados en la rederización
Esta gran pista me sirvió de inspiración... ¡eureka!, me di cuenta de que muchos de los resultados que estábamos viendo en los experimentos con JavaScript antes mencionados se podrían explicar perfectamente si tenemos en cuanta esta nueva información sobre este renderizado que hace Googlebot en la segunda oleada de indexación.
Cuándo dije que "Google indexa lo que permanece", era cierto! y ahora sabemos el por qué. Google en una segunda oleada, entrará en la url del experimento y obtendrá el HTML, pero renderizará el DOM y ejecutará JavaScript, por lo que cargará el contenido de cada uno de los diferentes escenarios planteados en el experimento, recordamos cuáles eran:
- Carga de contenido tras pasar entre uno y cinco segundos
- Carga de otro contenido tras pasar entre 5 y 10 segundos
- Carga de otro contenido diferente al trasnscurrir al menos 10 segundos).
Resumiendo podemos decir que una vez renderizado el documento por parte de Googlebot, el contenido que en él haya será el contenido que se indexe, y aquel contenido que no esté, no se indexará.
¿Cómo podemos saber que urls esta renderizando?
Un tema muy importante es saber qué urls está renderizando Google y cada cuánto tiempo lo hace. Esto se convierte en algo crítico para el SEO en aquellas páginas webs basadas en JavaScript, sobretodo si no se realiza un prerenderizado desde el servidor para dárselo a Googlebot en la primera oleada.
En el SEO para webs en JavaScript conocer a qué contenido es capaz de acceder Google es indispensable para saber si está teniendo problemas a la hora de cargar ese contenido, también para saber cada cuánto renderiza las urls, y cuánto tiempo tarda desde que accede en la primera oleada hasta que lo hace en la segunda ya que durante ese intervalo de tiempo Google solo indexará el contenido obtenido sin renderizar durante la primera oleada.
Analizando los logs del servidor podemos sacar algunos puntos que se dan en todos los casos;
- Cuando Google accede a la url de origen, lo hace con el campo referer vacío.

- Los recursos cargados desde esa url de origen por parte del navegador, ya sean urls de contenido ajax, hojas de estilo o ficheros js llevan todas en el campo referer la url de origen.
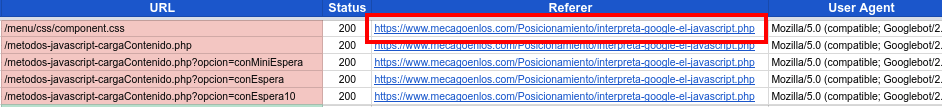
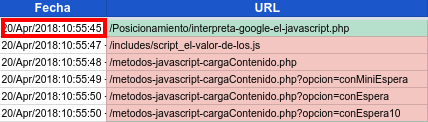
- Los accesos a la url de origen y a las urls o recusos cargados en el renderizado se dan en un pequeño periodo de tiempo, podemos decir casi al 100% que en un periodo de tiempo menor a un minuto.
- El User Agent con el que accede contiene "Googlebot", tanto para la url de origen como para las urls javascript o recursos cargados.
Y de forma menos general, pero que se suele dar cuándo Google renderiza una url
- Google a veces espera el tiempo definido en el setTimeout de JavaScript, pero a veces se salta ese tiempo de espera y ejecuta el javascript casi inmediantemanete.
- No siempre que accede a una url de origen la renderiza, la mayoría de las veces accede a la url pero no hay un renderizado posterior.
- No siempre carga todos los recursos o urls de contenido, a veces carga solo un css, a veces carga todos los recursos, a veces solo una url de contenido... deberemos investigar mejor este comportamiento y saber que no siempre carga todo ni siempre lo mismo.
Ejemplo SQL para saber las urls que Google renderiza
Si tenemos los logs en una base de datos con los siguientes campos, Fecha, path, Status, Referer, User Agent podriamos obtener las urls que han sido renderizadas obteniendo el valor del campo referer de las urls que cumplen estas dos condiciones;
- El User Agent contiene "Googlebot", por supuesto debemos comprobar que realmente sea Google, esto se puede hacer con un reverse DNS.
- El campo referer no está vacío, esto querrá decir que la url de este log ha sido cargada desde la url que aparece en e campo referer. En nuesto caso el valor de este campo es https://www.mecagoenlos.com/Posicionamiento/interpreta-google-el-javascript.php
Representando esto en SQL sería:
SELECT
fecha,
referer
FROM Logs
WHERE (UA LIKE '%Googlebot%') AND ((fecha >= '2018-03-01')
AND (fecha <= '2018-07-01')) AND (referer != '-')
GROUP BY
fecha,
referer
Y nos devolvería los siguientes resultados, dónde el campo "Referer" es la url de origen.
Con esto ya podemos saber qué y cuántas urls están siendo renederizadas diariamente por Google, y añadirlo así a nuestro dashboard.
Si quieremos ir un poco más allá y saber cuántas y qué urls están siendo cargadas desde cada url de origen también podemos conocerlo.
Hay un dato que TODAVÍA no he sido capaz de sacar y es cuántas veces ha sido renderizada una url. Este problema me lo planteó Iñaki Huerta, e ideó un método que podría ser el más cercano a este número, pero esto dejo que lo explique él.
Comentarios
Todavía no hay comentarios publicados.